
مقالات
تست بکاپ دیتابیس؛ چرا فایل بکاپ در زمان بحران کار نمیکند؟

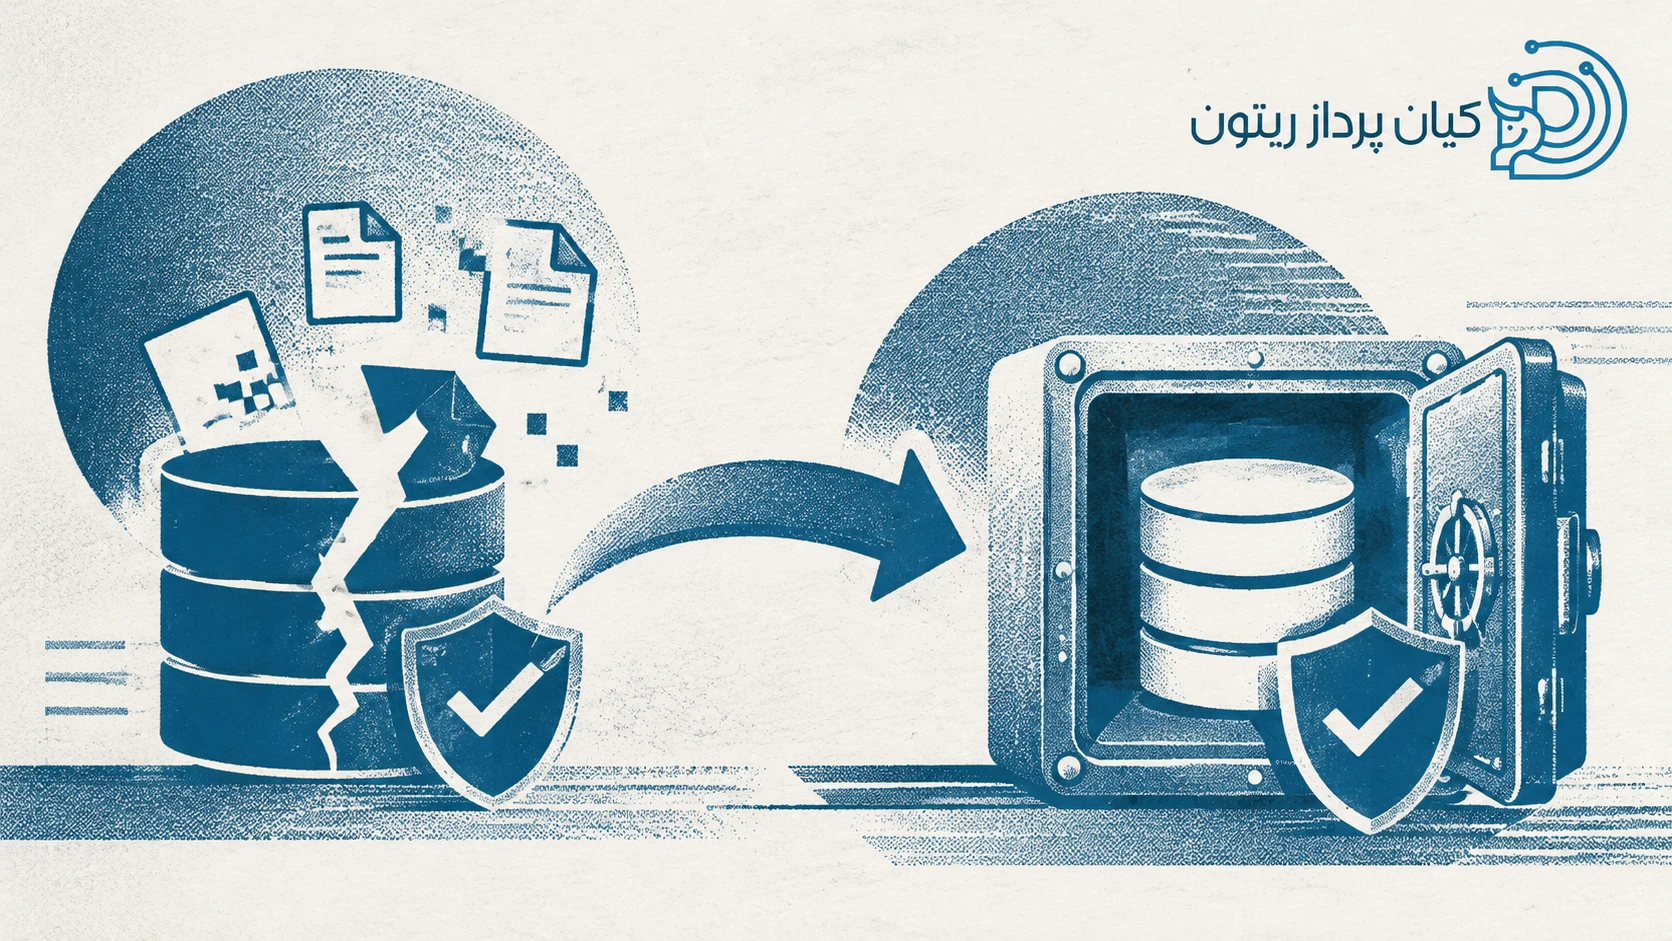
در تقویم کاری تیمهای فنی، DevOps و مدیران دیتابیس (DBA)، کمتر لحظه ای به اندازه بازگردانی دیتابیس اصلی یا همان Production در زمان بحران پر از استرس است. صفحه های مانیتورینگ قرمز شدهاند، سرویس ها از دسترس خارج شدهاند و نگاه کل کسبوکار و مدیران ارشد به تیم زیرساخت دوخته شده است.
در چنین شرایطی، معمولاً یک جمله مایه ی آرامش همه است: «نگران نباشید، فولبکاپ دیشب رو داریم!»
اما واقعیت تلخ اینه که در مهندسی زیرساخت که تا وقتی این فایل بکاپ با موفقیت در یک محیط واقعی بالا نیاید (Restore نشود) و ساختار جداول آن کوئری نخورد، شما در واقع «هیچچیزی» در دست ندارید؛ جز یک فایل چند گیگابایتی که ممکن است مجموعهای از بایتهای خراب، تراکنشهای نیمهکاره یا هدرهای خالی باشد.
💡 قانون بکاپ شرودینگر (Schrödinger’s Backup): در فرهنگ مهندسی SRE یک اصل معروف وجود داره که میگه: «وضعیت هر فایل بکاپ تا لحظهای که سعی نکنید آن را ریاستور کنید، ناشناخته است؛ یعنی همزمان هم سالم است و هم خراب!»
در این مقاله تخصصی، بررسی میکنیم که چرا اسکریپت های بکاپ گیری با وجود نمایش تیک سبز به ما دروغ میگویند و چگونه میتوانیم با یک پایپ لاین ساده و کمهزینه، فرآیند تست سلامت بکاپ دیتابیس (Automated Restore Verification) را به صورت ۱۰۰٪ خودکار پیادهسازی کنیم.
وقتی فایل حجم دارد ولی دیتایی داخلش نیست!
خیلی وقت ها اسکریپت های بکاپ گیری به ما حس امنیت کاذب میدهند. اسکریپت شبانه اجرا میشود، با Exit Code 0 کارش را تمام میکند، فایل .tar.gz یا .dump تولید میشود و سیستم مانیتورینگ هم تیک سبز نشان میدهد. حتی حجم فایل هم روی دیسک کاملاً منطقی به نظر میرسد؛ اما وقتی روز حادثه کار به ریکاوری میرسد، همهچیز خراب میشود. چرا؟
چهار سناریوی کلاسیک وجود دارد که در آنها فایل بکاپ بدون تولید هیچ خطای ظاهری، عملاً غیرقابل استفاده میشود:
۱. تلهی Pipe در لینوکس و دروغ بزرگ Exit Code 0
بسیاری از ادمین ها خروجی دستور بکاپ را مستقیماً به ابزارهای فشرده سازی یا رمزنگاری Pipe میکنند مثلاً:
# یک الگوی رایج اما خطرناک در اسکریپتهای Bash:
pg_dump -U postgres prod_db | gzip > /backups/prod_db.sql.gzدر رفتار پیشفرض شل Bash، کد خروجی (Exit Code) یک پایپلاین، فقط بر اساس آخرین دستور زنجیره (یعنی gzip) تعیین میشود! اگر دستور pg_dump یا mysqldump در میانه راه به دلیل کمبود حافظه یا قطع اتصال کرش کند، استریم بسته میشود، دستور gzip هرچه تا آن لحظه دریافت کرده را به زیبایی فشرده میکند و با Exit Code 0 به کار خود پایان میدهد! اگر در ابتدای اسکریپت های خود دستور حیاتی set -euo pipefail را قرار نداده باشید، مانیتورینگ شما سال ها تیک سبز برای فایل های نصفه نیمه ثبت خواهد کرد.
۲. تراکنشهای طولانی (Long-running Transactions) و ناهماهنگی زمانی
تصور کنید درست در میانه فرآیند گرفتن دامپ، یک کوئری سنگین گزارشگیری یا یک Lock طولانی در دیتابیس در حال اجراست. اگر ابزار بکاپگیری شما بدون فلگ های ایزولاسیون تراکنش (مانند --single-transaction در MySQL یا مکانیزم Snapshot در PostgreSQL) اجرا شود، جداول به صورت ترتیبی خوانده میشوند. نتیجه چیست؟ جدول سفارشها در ساعت ۰۲:۰۰ بامداد و جدول تراکنشهای مالی در ساعت ۰۲:۴۵ بکاپ گرفته میشوند. هنگام بازگردانی، دیتابیس با کلیدهای خارجی شکسته (Broken Foreign Keys) و داده هایی که از نظر منطقی با هم جور در نمی آیند (Inconsistent State) بالا میاد.
۳. قطعیهای میلیثانیهای شبکه و استوریجهای ابری (S3 / MinIO / NFS)
در معماری های مدرن، معمولاً خروجی بکاپ به صورت استریم مستقیم روی استوریج های شیءگرا (مانند MinIO یا AWS S3) یا درایوهای شبکه (NFS) نوشته میشود. گاهی یک نوسان یا تایماوت چند میلیثانیه ای در شبکه رخ میدهد؛ فرآیند فشرده سازی تصور میکند استریم دیتا به پایان رسیده و فوتر فایل را می بندد، در حالی که نیمی از رکوردهای انتهای جدول هرگز به مقصد نرسیده اند!
۴. ناسازگاریهای نسخهای (Version Skew) و کلیدهای رمزنگاری منقضیشده
فایل بکاپ بدون مشکل ذخیره شده ، اما با کلید GPG یا KMS قدیمی رمزنگاری شده که دیگر روی سرور جدید وجود ندارد. یا در سناریویی رایجتر، نسخه ابزار کلاینت یا موتور دیتابیس در محیط بازیابی (Target) تنها یک نسخه فرعی (Minor Version) پایینتر یا متفاوت از دیتابیس مبدا است و درست در لحظه ریاستور، با خطای ناسازگاری فرمت باینری متوقف میشود.
لحظه فاجعه: اینجاست که وسط اوج استرس و در حالی که کسبوکار متوقف شده، ترمینال دیتابیس خطای Corrupted header، unexpected EOF یا خطای یکپارچگی دیتا را جلوی چشمانتان چاپ میکند؛ لحظهای که آرزو میکنید کاش زمین دهان باز میکرد!
قانون طلایی: بیخیال واژه «بکاپ» شوید، از «استراتژی ریاستور» حرف بزنید!
در مهندسی مدرن قابلیت اطمینان سایت (SRE)، اصلاً چیزی به نام «هنر بکاپگیری» وجود ندارد؛ تمام ماجرا به «استراتژی بازیابی (Restore Strategy)» برمیگردد.
تفاوت این دو مفهوم از زمین تا آسمان است. شما فایل بکاپ را برای این تولید نمیکنید که فضای هارددیسک را پر کنید یا در ممیزی های فنی تیک بزنید؛ شما بکاپ میگیرید که روز مبادا دیتای سازمان زنده شود. در استانداردهای نوین حفاظت از داده، قانون قدیمی 3-2-1 به قانون 3-2-1-1-0 ارتقا یافته است که در آن عدد صفر (0) در انتهای فرمول به معنای «صفر خطا در تست خودکار و روزانه/هفتگی بازگردانی بکاپ» است.
اگر سیستمی ندارید که حداقل هفته ای یکبار به صورت خودکار سراغ فایل های بکاپ برود، آنها را روی یک محیط ایزوله زنده کند و از جداولش کوئری بگیرد، شما بکاپ ندارید؛ بلکه فقط دارید برای خودتان توهم امنیت میخرید!
مقایسه سطوح بلوغ اعتبارسنجی بکاپ در سازمانها
در جدول زیر میتوانید بررسی کنید که زیرساخت فعلی سازمان شما در کدام سطح از اطمینان قرار دارد:
| سطح بلوغ | روش بررسی | چه خطا هایی را کشف میکند؟ | ریسک شکست در زمان بحران |
|---|---|---|---|
| سطح ۰ (توهم کامل) | بررسی Exit Code 0 و وجود فایل روی دیسک | فقط قطعی کامل دیسک یا اجرا نشدن Cronjob | بسیار بالا (فایلهای ۰ بایتی یا ناقص) |
| سطح ۱ (بررسی ظاهری) | کنترل حجم فایل، هش SHA256 و تست آرشیو (gzip -t) | خرابی ساختار فایل فشرده در حین انتقال شبکه | متوسط رو به بالا (عدم تشخیص خرابی منطقی SQL) |
| سطح ۲ (ریاستور فیزیکی) | بازگردانی خودکار در کانتینر موقت (Ephemeral) | خطاهای هدر، Syntax Error، ناسازگاری نسخه و رمزنگاری | پایین |
| سطح ۳ (استاندارد طلایی SRE) | ریاستور خودکار + اجرای Smoke Test + ثبت زمان RTO | تمامی خطاهای فیزیکی، منطقی، دیتای قدیمی (Stale) و کندی ایندکسها | نزدیک به صفر (اطمینان ۱۰۰٪) |
چطور توهم را بشکنیم؟ (چک لیست ۴ مرحله ای خودکارسازی تست بکاپ)
برای اینکه خیالتان از سلامت بکاپ ها راحت شود، نیازی نیست هر روز یک مهندس به صورت دستی فایل ها را ری استور کند یا هزینه های سنگین سخت افزاری به شرکت تحمیل شود. کافی است این فرآیند ۴ مرحلهای را با یک پایپلاین ساده (در GitLab CI، Jenkins یا حتی یک Cronjob روی سرور تست) خودکار کنید:
۱. ریاستور کردن در محیطهای موقت (Ephemeral Environments)
اسکریپتی بنویسید که به صورت دوره ای (مثلاً هفته ای یکبار یا هر شب برای دیتابیسهای حیاتی)، آخرین فایل بکاپ را از استوریج دانلود کرده، رمزگشایی کند و داخل یک کانتینر سبک Docker یا یک ماشین مجازی موقت بالا بیاورد. همین که موتور دیتابیس بتواند فرآیند import یا pg_restore را بدون خطای هدر و کرش پشت سر بگذارد، نیمی از مسیر اعتبارسنجی را رفته اید.
۲. اجرای Smoke Test روی دیتای ریاستور شده
صرفاً بالا آمدن Engine دیتابیس کافی نیست. اسکریپت شما باید پس از اتمام ری استور، به دیتابیس وصل شود و چند کوئری اعتبارسنجی Smoke Test اجرا کند:
- شمارش تعداد رکوردهای ۵ جدول اصلی کسب و کار (مثلاً کاربران، سفارشها، تراکنشها) و اطمینان از اینکه جدولها خالی نیستند.
- بررسی ستون
created_atآخرین رکورد ثبت شده تا مطمئن شوید بکاپ واقعاً مربوط به ۲۴ ساعت گذشته است و اسکریپت به اشتباه فایل ماه گذشته را برنداشته است (کنترل شاخص RPO). - بررسی سلامت کلیدهای خارجی (Foreign Keys) و ایندکس ها برای اطمینان از نبود قفل های نصفه کاره در زمان دامپ.
۳. اندازهگیری زمان واقعی ریکاوری (محاسبه دقیق RTO)
روی کاغذ همه تصور میکنند یک دیتابیس ۱۰۰ گیگابایتی ظرف نیمساعت برمیگردد. اما وقتی اسکریپت واقعی اجرا میشود، متوجه میشوید که فقط مرحله بازسازی ایندکسها (Index Rebuild) و بررسی قیدها ۳ ساعت زمان برده ! ثبت مدت زمان اجرای این اسکریپت به شما کمک میکند شاخص RTO (Recovery Time Objective) واقعی را به دست آورید و در جلسات بحران، به مدیر محصول یا مدیرعامل یک عدد دقیق و مهندسی برای زمان بازگشت سرویس اعلام کنید، نه حدس و گمان!
۴. تمیزکاری خودکار و ارسال آلارم سلامت
بلافاصله پس از اتمام تست، اسکریپت کل کانتینر و والیوم موقت را Destroy میکند تا هیچ هزینه اضافی یا ریسک امنیتی از بابت نگهداری دیتای پروداکشن روی سرور تست باقی نماند. در نهایت، گزارش تست (شامل حجم فایل، تعداد رکوردها و زمان دقیق ریاستور) به کانال تلگرام، اسلک یا سامانه مانیتورینگ ارسال میشود و اگر حتی یک خطا رخ دهد، آلارم با اولویت Critical تیم فنی را باخبر میسازد—قبل از اینکه پروداکشن واقعی از دست برود!
نمونه اسکریپت عملیاتی: اتوماسیون تست بکاپ PostgreSQL با Docker
برای اینکه بتوانید همین امروز این ۴ مرحله را در زیرساخت خود پیادهسازی کنید، در ادامه یک اسکریپت استاندارد Bash را آماده کرده ام که آخرین بکاپ PostgreSQL را در یک کانتینر موقت داکر بازگردانی کرده، Smoke Test اجرا میکند، زمان RTO را میسنجد و محیط را پاک سازی مینماید:
#!/usr/bin/env bash
# فعالسازی حالت سختگیرانه برای جلوگیری از دروغ گفتن Exit Code در لولهها
set -euo pipefail
BACKUP_FILE="/backups/latest_prod_db.sql.gz"
CONTAINER_NAME="ephemeral_pg_verify_$$"
DB_USER="postgres"
DB_NAME="verify_db"
START_TIME=$(date +%s)
cleanup() {
echo "[INFO] Cleaning up ephemeral container..."
docker rm -f "$CONTAINER_NAME" >/dev/null 2>&1 || true
}
trap cleanup EXIT
echo "[STEP 1] Starting ephemeral PostgreSQL container..."
docker run --name "$CONTAINER_NAME" -e POSTGRES_PASSWORD=verifypass -e POSTGRES_DB="$DB_NAME" -d postgres:16-alpine
# صبر برای آماده شدن سرویس دیتابیس داخل کانتینر
until docker exec "$CONTAINER_NAME" pg_isready -U "$DB_USER" >/dev/null 2>&1; do
sleep 2
done
echo "[STEP 2] Restoring backup file: $BACKUP_FILE..."
zcat "$BACKUP_FILE" | docker exec -i "$CONTAINER_NAME" psql -v ON_ERROR_STOP=1 -U "$DB_USER" -d "$DB_NAME" >/dev/null
echo "[STEP 3] Running Smoke Tests on restored data..."
USER_COUNT=$(docker exec "$CONTAINER_NAME" psql -U "$DB_USER" -d "$DB_NAME" -tAc "SELECT COUNT(*) FROM users;")
if [ "$USER_COUNT" -le 0 ]; then
echo "[CRITICAL] Smoke test failed! Users table is empty."
exit 1
fi
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))
echo "[SUCCESS] Backup verified successfully!"
echo "Total Users Verified: $USER_COUNT | Actual Restore Time (RTO): ${DURATION} seconds."پرسشهای متداول (FAQ) درباره تست سلامت بکاپ دیتابیس
۱. تفاوت تست یکپارچگی فایل (Integrity Check) با تست ریاستور (Restore Test) چیست؟
تست یکپارچگی (مانند چک کردن هش فایل یا دستور gzip -t) فقط تایید میکند که فایل در سطح سیستم عامل سالم است و بیت های آن دستکاری نشده اند؛ اما نمیتواند تضمین کند که محتوای داخل فایل از نظر ساختار SQL، کلیدهای خارجی و سازگاری با نسخه دیتابیس قابل بازگردانی است. تنها راه اطمینان ۱۰۰ درصدی، اجرای کامل فرآیند Restore و کوئری گرفتن از جداول است.
۲. برای دیتابیسهای چند ترابایتی که ریاستور کردن دامپ منطقی آنها ساعت ها طول میکشد چه راهکاری وجود دارد؟
در دیتابیسهای حجیم (VLDB)، به جای استفاده از بکاپهای منطقی (مانند pg_dump یا mysqldump)، باید از ابزارهای بکاپگیری فیزیکی و افزایشی (Physical & Continuous WAL Archiving) مانند pgBackRest یا Percona XtraBackup به همراه قابلیت اسنپشات استوریج (ZFS / LVM / SAN Snapshots) استفاده کرد تا هم زمان بازگردانی (RTO) به چند دقیقه کاهش یابد و هم تست سلامت به سرعت انجام شود.
۳. تست خودکار بازگردانی بکاپ باید با چه فواصلی انجام شود؟
بسته به حساسیت کسب و کار، برای سامانه های مالی، بانکی و فروشگاههای بزرگ اینترنتی، اجرای روزانه (پس از هر بکاپ شبانه) و برای سایر سرویسها حداقل هفتهای یکبار به صورت کاملاً خودکار توصیه میشود.
حرف آخر: سوالی که باید فردا صبح در جلسه فنی بپرسید
سیستم ها خراب میشوند، دیسکهای سرورها میسوزند و خطای انسانی هم همیشه در کمین است. اما کابوس واقعی هیچکدام از اینها نیست فاجعه روزی رخ میدهد که فکر میکردید همهچیز امن است، ولی به لاگ ها و تیک های سبزی اعتماد کرده بودید که به شما دروغ میگفتند.
همین فردا صبح در جلسه استندآپ تیم فنی، یک سوال ساده از همکارانتان بپرسید:
«آخرین باری که واقعاً این فایل های بکاپ رو روی یک ماشین خام بالا آوردیم و از جداولش کوئری گرفتیم کی بوده؟»
اگر جوابی برایش ندارید یا پاسختان مربوط به ماه ها پیش است، بدانید که همین الان دارید روی لبه تیغ راه میروید و امروز بهترین زمان برای ساختن پایپلاین تست خودکار بکاپ هایتان است.