
مقالات
حل خطای Too Many Clients در PostgreSQL زیر بار ۵۰ هزار درخواست

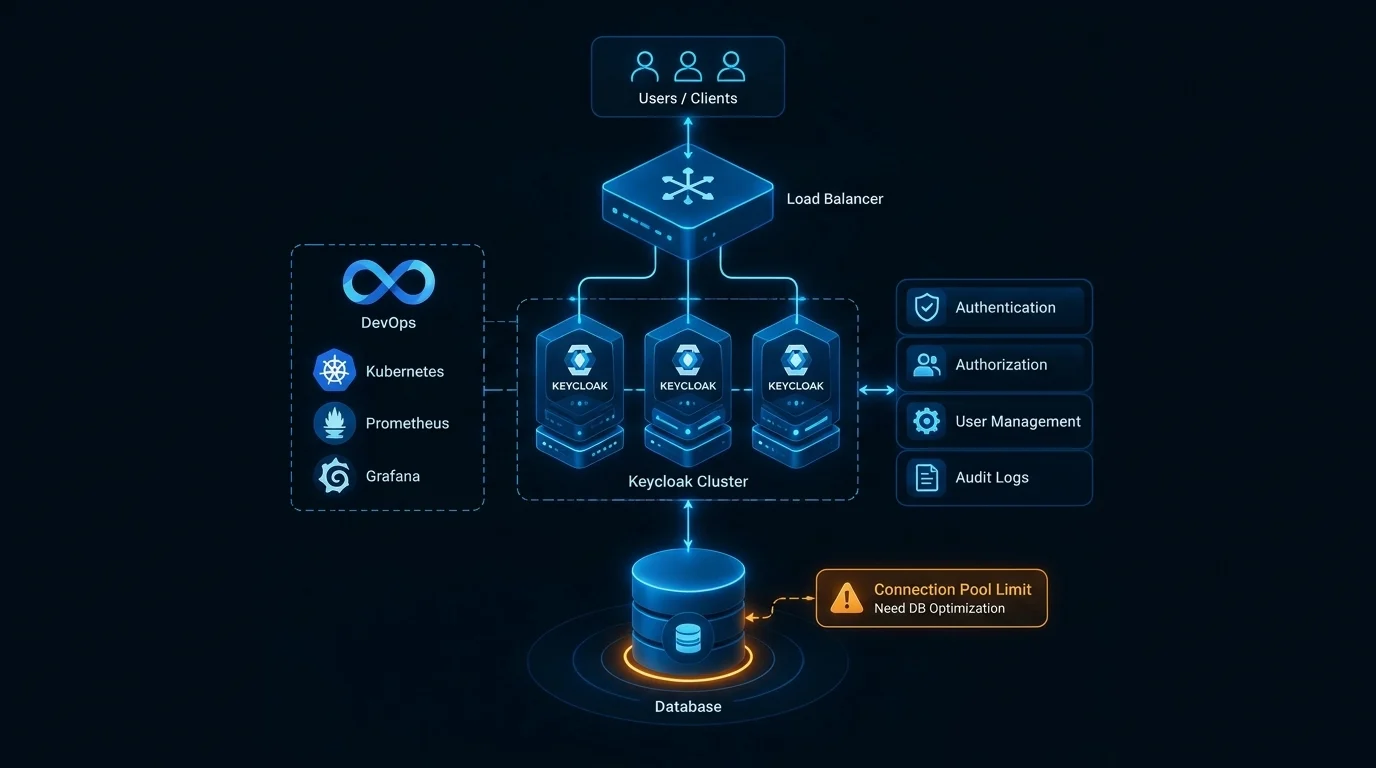
اگر سرویس احراز هویت شما روی Keycloak بچرخد و زیرساخت دیتابیس آن هم PostgreSQL باشد، احتمالاً روزی که ترافیک ناگهانی بالا میآید با یک سناریوی عجیب روبهرو میشوید؛ سناریویی که ما به سختی آن را تجربه کردیم و تصمیم گرفتم جزئیات کاملش را اینجا بنویسم تا شاید تیم دیگری مجبور نشود از صفر سرش را به دیوار بکوبد.
داستان از جایی شروع شد که یک Batch Job سنگین داخلی که هر شب اجرا میشود، یک شب ناخواسته دقیقاً با پیک ترافیک کاربران همزمان شد. نتیجه چه بود؟ سرویس احراز هویت بهطور کامل از دسترس خارج شد. کاربران نمیتوانستند لاگین کنند، توکنها رفرش نمیشدند و عملاً تمام سرویسهایی که به Keycloak متصل بودند بیدفاع ماندند.
نکته گمراهکننده ماجرا این بود که هیچکس در ابتدا به سراغ دیتابیس نرفت، چون همهچیز برعکس به نظر میرسید: مصرف CPU و RAM کلاستر کوبرنتیز کمتر از ۴۰ درصد بود، پادها سالم بودند و هلثچکها پاس میشدند. ظاهر قضیه میگفت «سیستم تحت فشار نیست». اما دیتابیس PostgreSQL به خاطر بالا رفتن بیش از حد تعداد کانکشنها عملاً قفل شده بود و درخواستهای جدید را نمیپذیرفت.
در این مطلب، ابتدا بررسی میکنیم چطور متوجه ریشه مشکل شدیم، سپس دو عامل اصلی اختلال را باز میکنیم و در نهایت سه تغییری را که برای پایدار شدن سیستم اعمال کردیم با جزئیات و کانفیگهای واقعی مرور میکنیم: مستقر کردن PgBouncer در حالت Transaction Pooling، محدود کردن کانکشنپول داخلی هر پاد در تنظیمات Quarkus، و تیونینگ Autovacuum برای جداول سشن.
اولین نشانهها: تصویرها و گرافهای گرافانا
وقتی ترافیک بالا رفت، اولین جایی که به آن سر زدیم داشبوردهای گرافانا بود. تصویری که آنجا دیدیم در نگاه اول اصلاً شبیه یک بحران نبود؛ بیشتر شبیه یک روز کاری معمولی بود که چیزی وسط آن خراب شده است.
پادهای Keycloak کاملاً سالم به نظر میرسیدند، مصرف پردازشیها پایین بود، رم پرفشار نبود و تعداد رپلیکاها (Replicas) هم طبق HPA بالا رفته بود. اگر فقط به داشبورد کوبرنتیز نگاه میکردیم، میگفتیم همهچیز مرتب است.
اما در سمت دیتابیس، دو خطای کاملاً مشخص ثبت شده بود. اول اینکه روی کلاستر دیتابیس که با Patroni مدیریت میشد، خطای معروف PostgreSQL ظاهر شده بود:
FATAL: sorry, too many clients alreadyاین خطا یعنی تعداد کلاینتهایی که سعی کردهاند به دیتابیس وصل شوند از سقف max_connections عبور کرده و Postgres به هر اتصال جدید جواب «نه» میدهد. دوم اینکه لاگهای Keycloak پر شده بود از پیامهای Connection timeout و Deadlock detected روی جداول سشن؛ یعنی تراکنشهایی که روی جداول user_session و client_session کار میکردند منتظر قفل همدیگر ماندند و بعد از رسیدن به deadlock_timeout، با شکست تمام میشدند.
ترکیب این دو نشانه یک معنی روشن داشت: مشکل نه از کمبود CPU بود و نه از کمبود رم. مشکل این بود که هزاران اتصال فیزیکی به دیتابیس زده شده بود و در همان حال، کوئریهای سشن هم به خاطر جداول سنگین، قفلهای طولانی تولید میکردند. به عبارتی دیتابیس از دو جهت همزمان در حال خفه شدن بود: از نظر تعداد اتصال و از نظر حجم کار روی جداول پر از رکورد مرده.
ریشهیابی: چرا دیتابیس قفل شد؟
بعد از جمع کردن لاگها و متریکها مشخص شد دو عامل دست به دست هم داده بودند تا این اختلال شکل بگیرد. جالب اینجاست که هیچکدام بهتنهایی سیستم را نمیانداخت؛ ترکیبشان بود که کار را تمام کرد.
عامل اول: اسکیل افقی پادها و انفجار کانکشنهای باز
وقتی ترافیک بالا رفت، HPA ما تعداد پادهای Keycloak را بهصورت افقی (Horizontal Scaling) زیاد کرد و این از نظر فنی اتفاق درستی بود. اشتباه جای دیگری بود: ما محدودیت سمت دیتابیس را حساب نکرده بودیم.
Keycloak برای مدیریت کلاستر و توزیع سشنها از کش Infinispan استفاده میکند و سشنها را در دیتابیس هم ذخیره میکند. مشکل اینجاست که بهصورت پیشفرض هر پادی که روی کوبرنتیز بالا میآید، کانکشنپول JDBC مستقل خودش را به دیتابیس باز میکند. یعنی تعداد اتصالهای واقعی به PostgreSQL از ضرب «تعداد پاد × اندازه کانکشنپول هر پاد» به دست میآید.
مثلاً اگر ۱۰ پاد Keycloak داشته باشید و هر پاد پیشفرض ۱۰۰ کانکشن در استخر خودش نگه دارد، تنها همین یک سرویس ۱۰۰۰ اتصال همزمان به دیتابیس میزند. این عدد برای Postgres که هر کانکشنش چند مگابایت حافظه مصرف میکند اصلاً شوخطبعی نیست. راهنماهای تیونینگ Keycloak هم دقیقاً همین نکته را تأکید میکنند که صرفاً بالا بردن max_connections جواب نیست، چون سربار هر اتصال بهمرور خودش تبدیل به گلوگاه میشود. نتیجه کار ما این شد که تعداد اتصالهای فیزیکی مستقیم به PostgreSQL به چند هزار رسید و دیتابیس از سقف مجازش رد شد؛ یعنی بدون اینکه بخواهیم در حال DDoS کردن دیتابیس خودمان با کانکشن بودیم.
عامل دوم: Table Bloat در جداول سشن
دومین عامل کمتر دیده میشود ولی از نوع اول مخربتر است. به خاطر تنظیمات پیشفرض زمان اعتبار توکنها و سشنها، رکوردهای منقضیشده با سرعت کافی از دیتابیس پاک نمیشدند.
معماری MVCC در PostgreSQL به این صورت کار میکند که هر UPDATE و DELETE یک تاپل مرده (Dead Tuple) پشت سر میگذارد و پاکسازی این تاپلها وظیفه فرآیند Autovacuum است. چون جداول user_session و client_session جزو جدولهای با نرخ نوشتن بالا هستند—هر لاگین یک رکورد میسازد و هر رفرش توکن همان رکورد را آپدیت میکند—تاپلهای مرده در این جدولها با سرعت غیرعادی انباشت میشدند.
با سنگین شدن این جداول، ایندکسها کاراییشان را از دست دادند و پلن اجرای کوئریهای سشن به سمت Sequential Scan منحرف شد. اسکن کامل یک جدول چند میلیون رکوردی یعنی قفلهای طولانی و صف بستن تراکنشها؛ همان چیزی که در لاگها به شکل Deadlock detected دیده میشد.
سه تغییر کلیدی برای شکستن حلقه بحران
مرحله اول: ایستاندن PgBouncer جلوی PostgreSQL
اولین و مهمترین تغییری که اعمال کردیم، برداشتن اتصال مستقیم پادها از روی دیتابیس و گذاشتن یک لایه میانی به اسم PgBouncer بین Keycloak و PostgreSQL بود.
ایده ساده است: به جای اینکه هر پاد کانکشن فیزیکی خودش را به Postgres نگه دارد، همه پادها به PgBouncer وصل میشوند و PgBouncer یک استخر محدود از اتصالهای فیزیکی واقعی به دیتابیس را مدیریت میکند. کانکشنهایی که پادها باز میکنند دیگر «اتصال واقعی» نیستند؛ فقط یک سوکت سبک به PgBouncer هستند که سربارش روی دیتابیس تقریباً صفر است.
نکته کلیدی ماجرا در انتخاب حالت Pooling است. PgBouncer سه حالت دارد: session، transaction و statement. ما حالت اتصال را روی Transaction Pooling گذاشتیم؛ یعنی pool_mode = transaction. تفاوتش با حالت session این است که در حالت session، اتصال فیزیکی تا وقتی کلاینت قطع نشده به همان کلاینت اختصاص دارد، اما در حالت transaction به محض پایان تراکنش، اتصال فیزیکی به Pool برمیگردد و در اختیار بقیه پادها قرار میگیرد. برای Keycloak که اتصالها را طولانی باز نگه میدارد، این حالت عملاً تنها حالتی است که هدف ماجرا را برآورده میکند.
نتیجه این تغییر این بود که پادها دیگر کانکشن فیزیکی را به مدت طولانی نگه نمیدارند؛ هر تراکنش سریع یک اتصال از استخر برمیدارد، کارش را انجام میدهد و برمیگرداند. چند هزار اتصال منطقی از سمت پادها روی چند ده اتصال فیزیکی به Postgres اصطلاحاً Multiplex شد و عدد اتصالهای واقعی دیتابیس از «چند هزار» به یک عدد ثابت و قابل پیشبینی رسید.
دو نکته عملیاتی در استقرار PgBouncer:
- مقادیر
max_client_connوdefault_pool_sizeدر فایلpgbouncer.iniرا باید بر اساس ظرفیت واقعی Postgres تنظیم کنید نه بر اساس تعداد پادها، چون حالا سقف واقعی اتصال به دیتابیس را PgBouncer کنترل میکند. - قبل از اعمال در پروداکشن، رفتار Prepared Statements و هر قابلیت خاص سمت Postgres را حتماً در حالت
transactionتست کنید تا بعد از مهاجرت غافلگیر نشوید. برای ما این مهاجرت خیلی روان بود، ولی این نکته را در محیط تست بررسی کردیم.
مرحله دوم: محدود کردن دیتاسورس در سطح Quarkus
PgBouncer کمک کرد تعداد اتصالهای واقعی به PostgreSQL کنترل شود، اما ما همزمان کانکشنپول داخلی هر پاد را هم محدود کردیم. چون اگر هر پاد دهها یا صدها درخواست را پشت صف نگه دارد و همزمان تعداد پادها بالا برود، باز هم فشار روی دیتابیس و منابع پادها زیاد میشود.
در نسخهای از Keycloak که استفاده میکردیم، تنظیمات دیتاسورس از طریق Quarkus قابل کنترل بود. این مقادیر را اعمال کردیم:
quarkus.datasource.jdbc.max-size=20
quarkus.datasource.jdbc.min-size=5
quarkus.datasource.jdbc.acquisition-timeout=10smax-size=20: سقف تعداد اتصالهایی را که هر پاد در Pool خودش نگه میدارد مشخص میکند. این عدد را نباید کورکورانه کپی کرد؛ باید با تعداد پادها، تعداد دیتابیسها و ظرفیت PgBouncer جمع زده شود. برای مثال اگر ۲۰ پاد داشته باشیم و هر کدام حداکثر ۲۰ اتصال درخواست کنند، سمت PgBouncer ممکن است تا ۴۰۰ کلاینت ببیند. این مسئله با تعداد اتصالهای فیزیکی Postgres فرق دارد، اما همچنان باید برای منابع PgBouncer و صف درخواستها ظرفیت در نظر گرفت.min-size=5: حداقل اتصالهایی را مشخص میکند که Pool برای آمادهبهکار ماندن نگه میدارد. اگر تعداد پادها زیاد باشد، همین حداقل بهتنهایی میتواند تعداد قابل توجهی اتصال ایجاد کند؛ بنابراین بهتر است مقدارش را با توجه به الگوی ترافیک تنظیم کنید.acquisition-timeout=10s: تعیین میکند پاد برای گرفتن اتصال از Pool چقدر منتظر بماند. قبل از این تغییر، درخواستها در شرایط فشار مدت زیادی پشت صف میماندند و منابع بیشتری اشغال میکردند. با Timeout محدود، اگر اتصال در زمان مشخص فراهم نشود درخواست شکست میخورد و خطا قابل مشاهده میماند، به جای اینکه صف بیانتها شود و کل سرویس با تأخیرهای زنجیرهای از کار بیفتد.
این تنظیمات جلوی فشار نامحدود را میگیرد اما به معنی حذف خطا نیست؛ در اوج بار بخشی از درخواستها ممکن است Timeout بگیرند. هدف این است که شکست کنترلشده داشته باشیم و سرویس اصلی از دسترس کامل خارج نشود. تنظیمات باید با آزمون بار و پایش نرخ خطا، زمان انتظار اتصال و تعداد اتصالهای فعال کالیبره شوند.
مرحله سوم: تیونینگ Autovacuum برای جداول سشن
کنترل اتصالها بهتنهایی کافی نبود؛ باید جلوی رشد بیرویه جداول نشست را هم میگرفتیم. در PostgreSQL حذف یک ردیف بلافاصله فضای فیزیکی آن را به سیستمعامل برنمیگرداند. Autovacuum ردیفهای مرده را علامت میزند تا فضا برای استفاده مجدد آماده شود و آمار جدول هم برای انتخاب پلن بهتر بهروز بماند.
مشکل این بود که آستانه پیشفرض Autovacuum برای جداول بزرگ با تغییرات پرتعداد ما مناسب نبود. وقتی جدول خیلی بزرگ باشد، ضریب پیشفرض ممکن است باعث شود قبل از شروع Vacuum تعداد زیادی رکورد مرده جمع شود. برای همین روی جداول اصلی سشنها آستانههای پایینتری گذاشتیم:
ALTER TABLE user_session SET (
    autovacuum_vacuum_scale_factor = 0.05,
    autovacuum_analyze_scale_factor = 0.02
);

ALTER TABLE client_session SET (
    autovacuum_vacuum_scale_factor = 0.05,
    autovacuum_analyze_scale_factor = 0.02
);
با این تنظیم، vacuum و analyze بر اساس درصد کمتری از تغییرات جدول فعال میشوند. مقدار 0.05 برای Vacuum یعنی ضریب مقیاس پنج درصد و 0.02 برای Analyze یعنی دو درصد. با این حال، معنیاش این نیست که به محض تغییر دقیقاً پنج درصد از همه ردیفها Vacuum فوراً اجرا میشود؛ PostgreSQL علاوه بر Scale Factor، آستانه پایه، وضعیت Workerها و منابع در دسترس را هم در نظر میگیرد. این پارامترها نقطه شروع هستند، نه نسخه ثابت برای همه محیطها.
ما بعد از اعمال تغییر، وضعیت n_dead_tup، زمان آخرین Vacuum و Analyze، اندازه جدولها و شاخصهای کندی کوئری را زیر نظر گرفتیم. اگر Workerهای Autovacuum به اندازه کافی نرسند یا I/O دیسک محدود باشد، پایین آوردن آستانه بهتنهایی کافی نیست و باید همزمان تنظیمات عمومی مثل تعداد Workerها و محدودیت هزینه Vacuum هم بررسی شود. راهنمای تیونینگ Keycloak هم تأکید میکند که نگهداری جداول نشست، وضعیت ایندکسها و Autovacuum را باید کنار هم دید نه جدا از هم.
نکته مهم درباره فضای دیسک: فرآیند Autovacuum فضای مرده را برای استفاده مجدد در همان جدول آزاد میکند، اما الزاماً فایل جدول را کوچک نمیکند یا به سیستمعامل پس نمیدهد. اگر جدول قبلاً خیلی متورم شده باشد، ممکن است نیاز به برنامه جداگانه برای بازسازی یا کاهش اندازه داشته باشید. این کار را نباید بدون سنجش اثر قفل و فضای دیسک در ساعات پرترافیک اجرا کرد.
نتیجه بعد از اعمال تغییرات
بعد از این سه تغییر، تعداد اتصالهای فیزیکی به PostgreSQL قابلکنترل شد، صف اتصالها زیر فشار کوتاهتر ماند و روند رشد جداول سشن هم آهستهتر شد. مهمتر از همه، دیگر با هر افزایش ناگهانی تعداد پادهای Keycloak، دیتابیس ناگهان با هزاران اتصال تازه روبهرو نمیشد.
با این حال، عدد ۵۰ هزار درخواست بهتنهایی شاخص کافی برای ظرفیتسنجی نیست. باید مشخص باشد منظور ۵۰ هزار درخواست در ثانیه است یا در یک بازه زمانی، چه سهمی از درخواستها به Keycloak میرسد، نسبت لاگین به رفرش توکن چقدر است و هر درخواست چند عملیات دیتابیسی تولید میکند. چون اعداد دقیق آزمون بار و مقایسه قبل و بعد در این روایت ثبت نشده، نمیخواهم ادعا کنم این تغییرات بهتنهایی ظرفیت مشخصی را تضمین میکنند. نتیجهای که میتوانم با اطمینان بگویم این است که رفتار سیستم قابلپیشبینیتر شد و گلوگاه اتصال از حالت انفجاری خارج شد.
چکلیست عیبیابی برای تیمهای فنی
برای تیمی که با وضعیت مشابه روبهرو شده، ترتیب بررسی پیشنهادی ما به این صورت است:
- ابتدا تعداد اتصالهای فعال و سقف
max_connectionsرا با هم مقایسه کنید. - سپس تعداد پادها و حداکثر Pool هر پاد را حساب کنید.
- در نهایت خطاهای Timeout و Deadlock را در لاگها با وضعیت جداول سشن و آمار Autovacuum تطبیق دهید. بالا بردن CPU و RAM وقتی دیتابیس به خاطر اتصال یا عملیات نگهداری جدول قفل شده، درمان مسئله نیست.
جمعبندی تجربه ما خیلی ساده است: اسکیل کردن Keycloak بدون محاسبه تعداد اتصالهای دیتابیس میتواند گلوگاه را فقط از پادها به PostgreSQL منتقل کند. PgBouncer برای کنترل اتصالهای فیزیکی، محدودیت Pool در هر پاد برای جلوگیری از رشد بیحساب و تنظیم Autovacuum برای مدیریت جداول پرتغییر، سه بخش از یک راهحل بودند. هر کدام بهتنهایی جای پایش و آزمون بار را نمیگیرد، اما کنار هم جلوی تکرار همان سناریویی را گرفتند که یک روز با همزمان شدن یک Batch Job و پیک ترافیک، کل لایه احراز هویت ما را از دسترس خارج کرده بود.
برای بررسی بیشتر، مطالعه راهنمای تیونینگ پایگاه داده Keycloak و مرجع پیکربندی PgBouncer مفیدند.